阿里安全团队 投稿
量子位 | 公众号 QbitAI
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
细微图像扰动、视觉文字或跨模态提示可能绕过安全对齐,让模型回答原本应拒绝的有害问题。已有攻击在AdvBench上甚至能诱导对齐模型回答96%的不安全问题。
现有检测器往往只能在准确率、泛化能力和效率之间取舍。对此,中国人民大学与阿里巴巴集团联合提出Learning to Detect(LoD):不使用任何越狱攻击样本,也不依赖手工启发式规则,而是从LVLM的逐层内部激活中学习通用安全模式,把未见攻击识别为偏离安全分布的异常。
LoD学习的不是“某一种攻击长什么样”,而是“安全输入在模型内部应该呈现什么模式”。
为什么需要新的检测范式
越狱检测的核心困难并不只是判断“输入是否有害”,而是判断一个表面上经过伪装、重写或视觉扰动的输入,是否正在诱导模型绕过安全边界。现实中的攻击形式不断变化,检测器很难提前穷举未来攻击。
三类输入不能混为一谈
安全输入:内容无害,模型通常正常回答。
普通有害输入:直接表达危险意图,但没有经过越狱变换;对齐模型通常拒答。
攻击输入:通过视觉编码、提示操纵或对抗扰动隐藏危险意图,可能让对齐模型重新回答有害问题。
特别说明:论文训练MSCAV时使用的是普通有害输入,而不是由FC-Attack、HADES等方法生成的越狱攻击数据;所有攻击样本直到测试时才出现。
现有方案的两难
学习式检测方法可在已见攻击上获得较高准确率,但容易记住攻击特征,面对新攻击时泛化受限;免训练方法通过人工规则、拒答词或梯度特征规避攻击数据依赖,却可能在复杂场景中精度不足,并带来额外计算开销。
LoD的四项核心贡献
提出不依赖攻击数据或手工启发式规则的可学习检测框架。
用MSCAV从逐层内部激活中提炼紧凑、安全聚焦的表征。
用SPAE将高维安全表征压缩为可比较的一维异常分数。
在三种LVLM、六类未见攻击与五种基线上验证准确率、泛化和效率。
研究方法:从逐层安全表征到异常检测
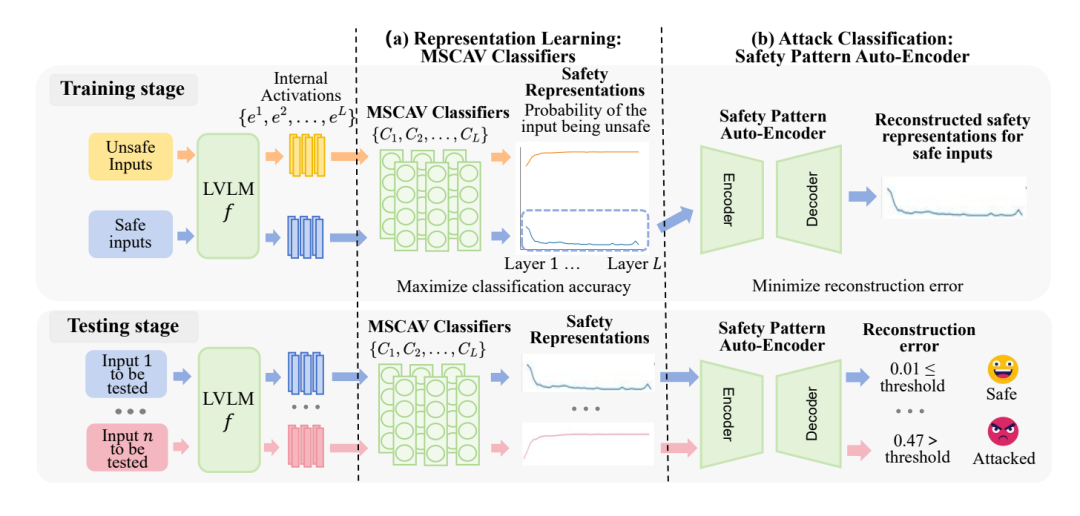
LoD包含表示学习与攻击分类两个模块。前者寻找模型内部真正与安全相关的信号,后者学习安全信号的典型分布;二者协同避免了直接使用高维激活的噪声,也避免为每一种攻击单独设计检测规则。
第一步:提取LVLM的逐层内部激活
给定多模态输入I,LoD读取各层最后一个输入token的隐藏状态eˡ。这些激活同时包含语义、视觉结构、情感和安全风险等信息,因此不能直接拼接后用于检测。
第二步:MSCAV学习安全相关方向
团队在每一层训练轻量线性分类器Cˡ,用安全输入与普通有害输入学习安全相关方向。分类器输出的不安全概率构成逐层安全表征;验证准确率达到P0=0.9的层进入安全感知层集合Ls,从而过滤任务无关噪声。
第三步:SPAE只学习安全样本的典型模式
SPAE采用三层全连接编码器与对称解码器,仅用安全输入的安全表征训练。编码器压缩跨层安全模式,解码器尝试还原;安全输入位于学到的安全流形附近,因此通常能被准确重构。
第四步:用重构误差识别未见攻击
测试时,LoD生成安全表征Sr并计算SPAE重构误差δ。低误差表示输入接近安全分布;高误差表示内部安全模式异常,δ超过阈值τ时标记为攻击。在线检测不需要反向传播,也不修改自回归解码。
关键机制:Ŝr=fdec(fenc(Sr));δ=
天元证券提示:文章来自网络,不代表本站观点。